roomiverse

築覓空間

用一句話佈置真實房間:AI 理解需求、擺放 3D 家具,再用幾何規則確認動線與空間真的可用。

搬家時,我很難想像家具放進去的樣子

SketchUp 做得到,但我只想多試幾種擺法,不想先學專業軟體。我想要的是:說「沙發靠窗」,就看到房間改好。

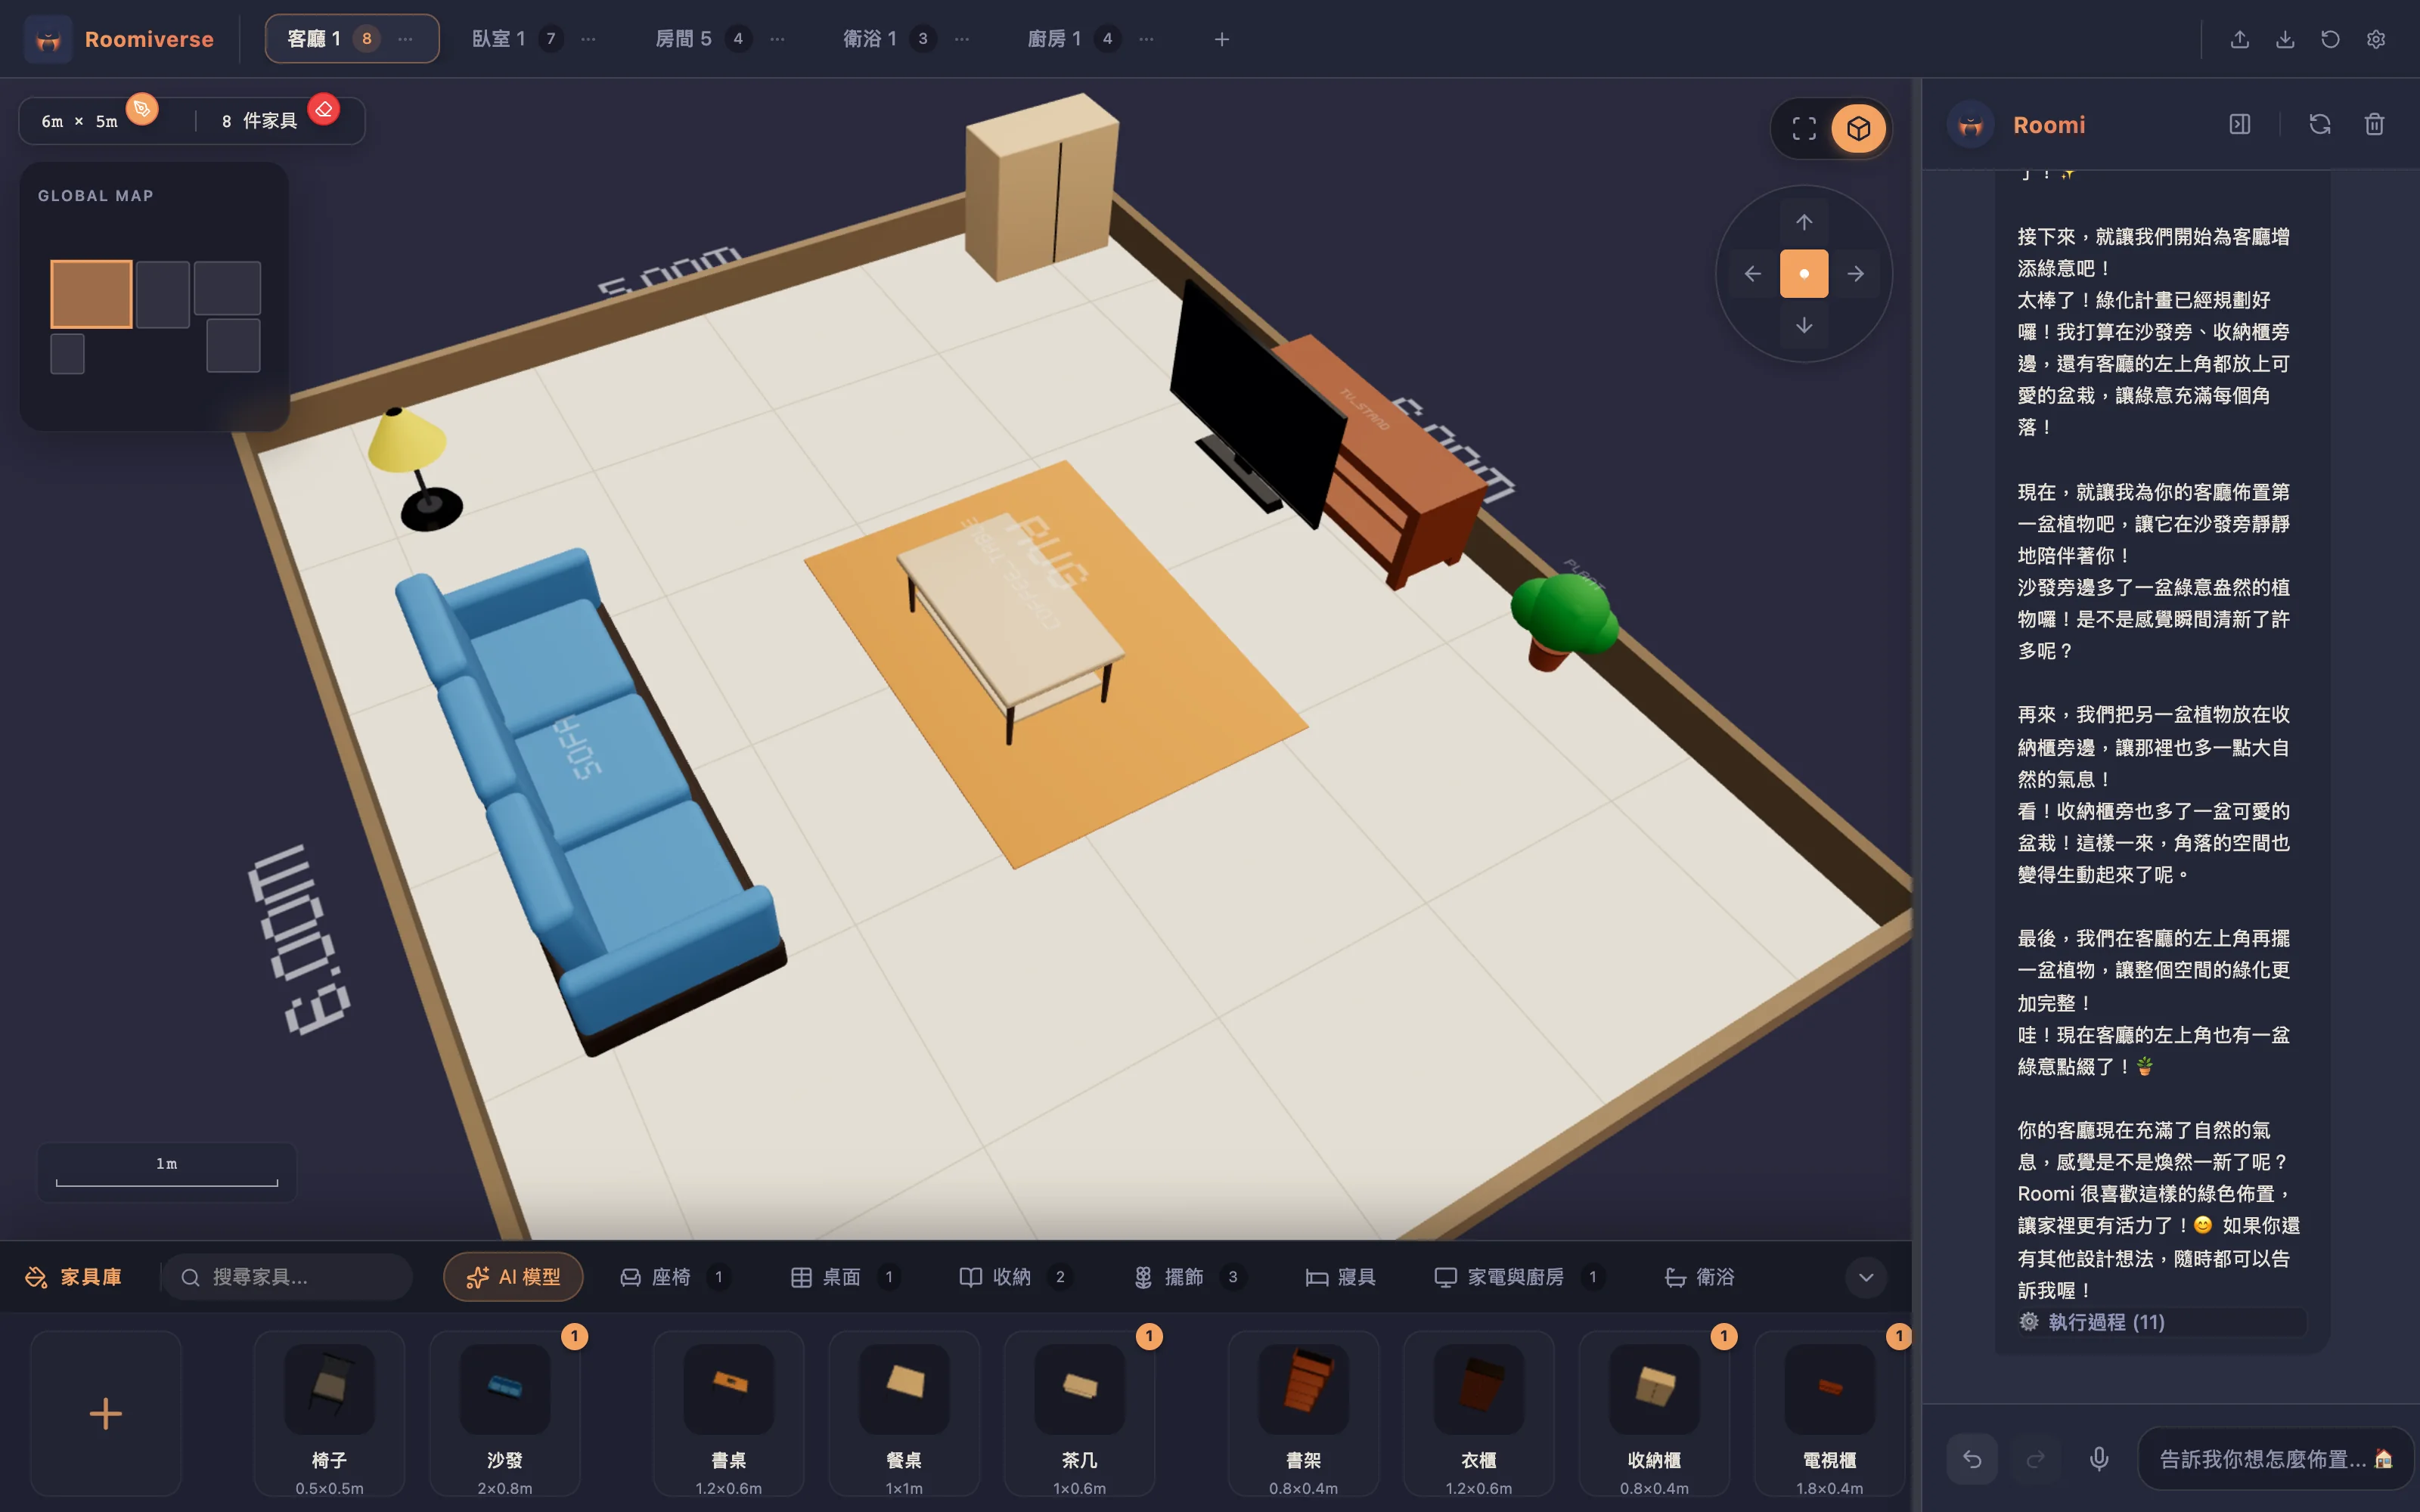
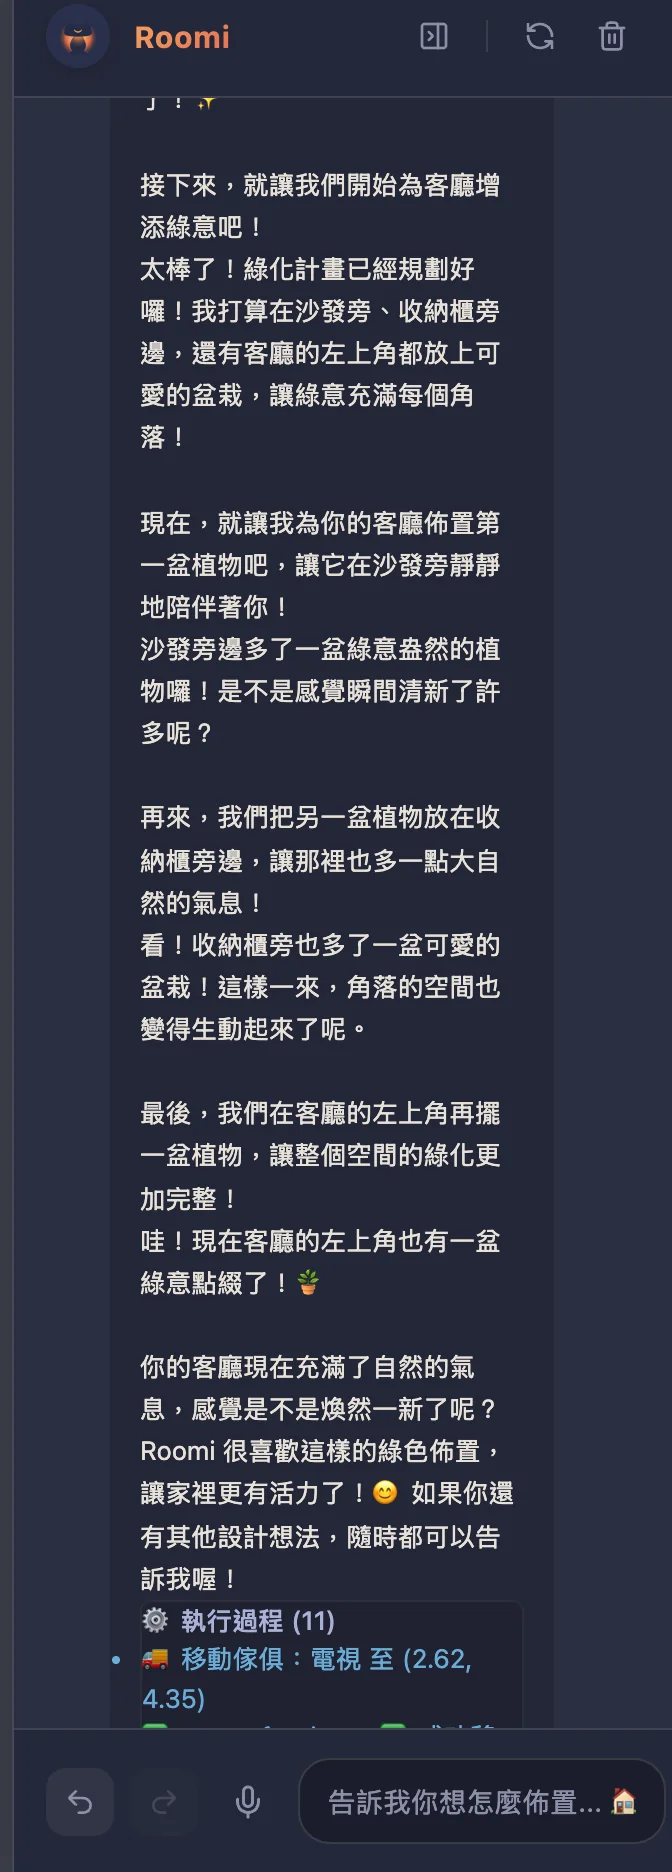
編輯器的實際畫面:請 Roomi「幫我綠化客廳」之後。

一句話,怎麼變成房間裡的家具

整個產品就是這條路。AI 只負責其中幾步,其他都交給程式把關。

看技術元件與實際修改紀錄

做法

  1. Intent Compiler把請求整理成需求,不給任何工具
  2. Planner需要時排出步驟順序,不能增減需求
  3. Executor只拿到這次需要的工具
  4. Mutation Guard每次寫入前檢查範圍和位置
  5. Skills用一般程式碼計算擺放位置
每次修改都留下紀錄:用了哪個工具、移了什麼。

對話能驅動的能力

Pass rate and median duration by capability type 理解 修改 修正 佈置 美感 對話 誠實 環境

通過率與處理時間,按能力類型

  • 通過率
  • 處理時間

除了對話,還能這樣用

AI 功能

照片轉家具

上傳家具照片後生成 3D 模型;素材不足時回退到可編輯的程序式家具,讓佈置流程不被單一模型卡住。

家具照片 AI 生成 3D 模型 放進房間

AI 功能

平面圖建模

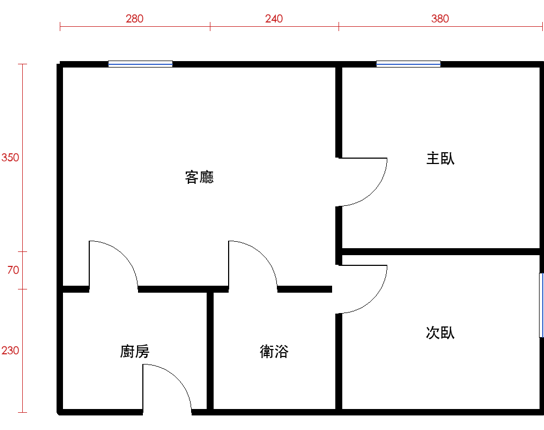
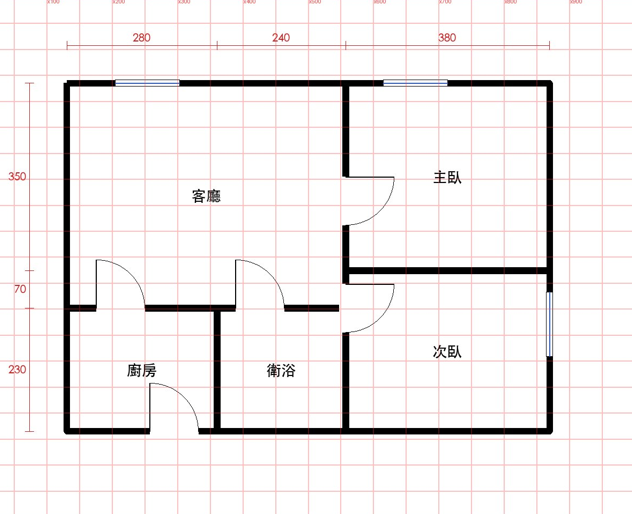
系統分階段辨識房間、牆面與比例尺;使用者先檢查結果、確認之後才建立 3D 空間。

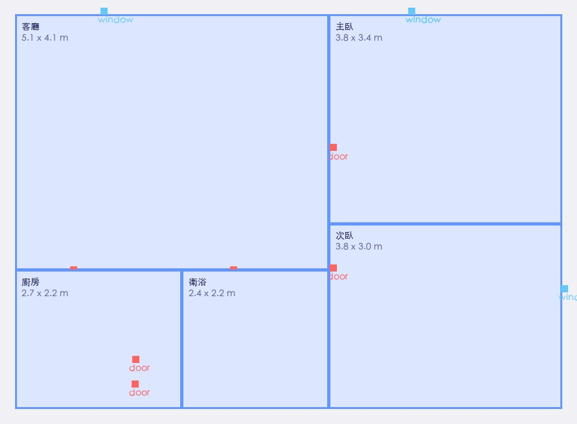
原始平面圖 疊上座標格線 換算成公尺

隨時手動接手

拖曳、縮放、旋轉與座標輸入都保留,手動修改和 AI 操作共用同一條 undo 歷史,使用者隨時可以修正或停止。

做法與驗證

調教 AI 的幾個小技巧

  • 先想清楚,再給工具整理需求時完全不給工具,AI 想動手也動不了。
  • 只給這次用得到的工具沒拿到刪除工具,就不可能順手刪掉家具。
  • 位置交給程式算碰撞、出界這些幾何問題,不靠 AI 猜。
  • 錯了就告訴它為什麼碰撞時把錯誤回傳給 AI,讓它自己重新擺放。
  • 只說不做,就再推一次AI 宣布了計畫卻沒動手時,要求它接著做完。
  • 每次都給最新的房間把當下的房間狀態放進指示,不靠 AI 記憶。

模型給的座標會讓家具重疊

第一版由模型直接回傳座標,沙發會穿牆、桌子疊在床上、檯燈浮在半空。

結果61 個情境、兩個模型,家具出界都是 0 次。

看做法

做法

  • 碰撞時把錯誤回傳給模型,讓它重新擺放
  • 真的找不到位置時,用螺旋搜尋找最近的空位
  • 房間狀態改由伺服器保管,前端只負責顯示
  • 之後擴充成四項幾何檢查,全部不經過模型:
    • 碰撞collision
    • 出界bounds
    • 使用空間use_zone
    • 可通行navigability

AI 和使用者同時修改,會互相覆蓋

使用者在 AI 執行中拖動家具,兩邊的修改會蓋掉對方。

結果AI 執行時使用者的修改不再被覆蓋,AI 的整次修改也能一步復原。

看做法

做法

  • AI 執行時房間上鎖,畫面顯示它正在做什麼
  • 隨時可以停止,已完成的保留,未完成的不寫入
  • AI 一次做的所有修改,合併成一步 undo
  • 重新整理頁面,鎖和進度都還在
  • 刪除多件家具前先確認;指令不清楚時先追問

平面圖存進資料庫時,比例尺從來沒套用

原本是兩個 agent:Drafter 讀圖建房間、Surveyor 審查算比例尺。查程式才發現 Surveyor 算出的比例尺從來沒被套用——房間尺寸其實是格線格數,卻直接當成公尺存進資料庫,每個匯入的房間因此放大 2–3.5 倍;一間 5.2×4.2 公尺的客廳被存成 13×12.5 公尺。

結果自建的評測工具跑了 7 輪:最後拿掉 Surveyor、也拿掉 Phase 0 標註、全部改用同一套正規化座標,配置 IoU 從 0.07 拉到 0.82,真實平面圖的比例尺誤差從 +150% 降到 −1%/+3%,每次匯入成本從 $0.087 降到 $0.002–0.014(約省 85–98%),而且只需要一把 OpenRouter 金鑰,不用再接 Google。

看做法

做法

  • 拿掉 Surveyor 這個 LLM 審查員,改成單一 Drafter 加上確定性的程式檢查:房間重疊、尺寸不合理(含房型上限)、整張圖跨度、物件沒落在任何房間裡、缺比例尺——只有檢查沒過時,才給 Drafter 一次修正機會
  • 修好比例尺的 bug:草稿先放在記憶體裡,換算成公尺後才一次寫入資料庫
  • 房間、門窗、家具、比例尺參考全部改用同一套座標(Gemini 原生的 box_2d,正規化到 0–1000),模型讀座標的系統性偏差換算成公尺時會互相抵消;物件由程式依中心點自動歸到所在房間
  • 自己寫評測工具:4 張用程式產生、有精確答案的合成平面圖,加 1 張玩家上傳的真實平面圖(比例尺從圖上標註的尺寸推回來);指標是對齊後的房間 IoU、面積誤差、比例尺誤差,還有實際 token 成本,另外做了疊圖工具,能把正確答案和模型結果畫在一起比對
  • 數據否決了我自己加的一個檢查:門寬合理性檢查在實測時反而讓修正那一輪把本來正確的比例尺改錯(−11% 變成 +117%),所以拿掉了
  • 用同一套評測比較了 4 個模型,再依數據選
  • 最後連 Phase 0(AI 把平面圖重畫一次、上色標註)也拿掉:在乾淨的合成圖上有幫助,但在真實平面圖上反而有害,還佔每次匯入成本的 95%——拿掉後合成圖準確率小降(0.91→0.82),但真實圖的比例尺誤差從 +45%/+91% 大幅改善成 −1%/+3%,成本也降到約二十分之一;只看合成圖會選錯,真實資料才是關鍵
  • 過程中抓到一個正式環境也會發生的 bug:推理型模型把 4096 token 的輸出上限全用在思考,結果得到 0 個房間;已把視覺角色的輸出上限調到 16384
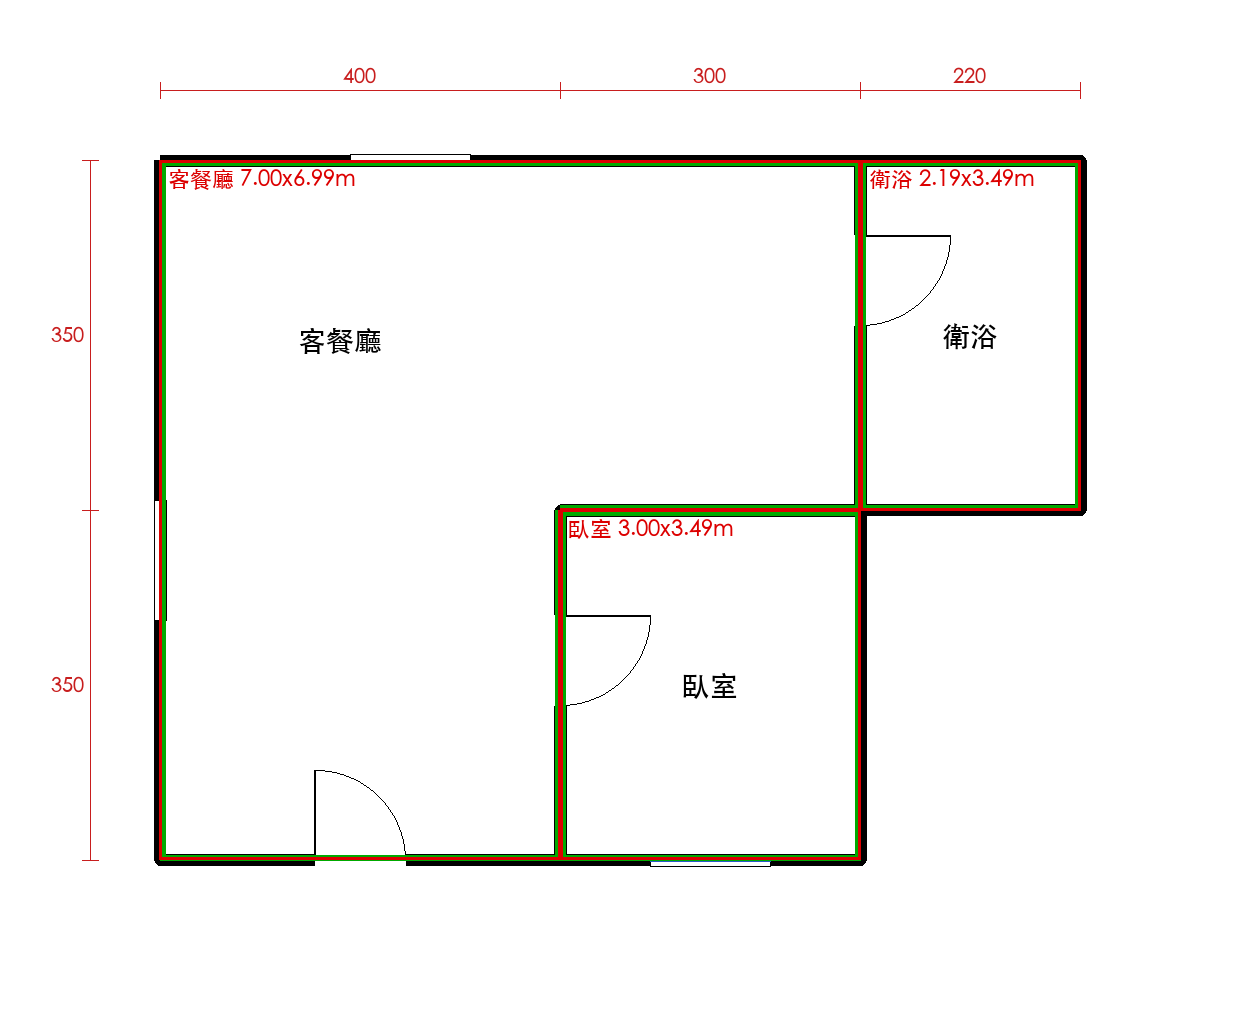
L 形客廳,配置 IoU 0.96(最終版本,不跑 Phase 0;綠線是正確答案,紅線是模型結果)。
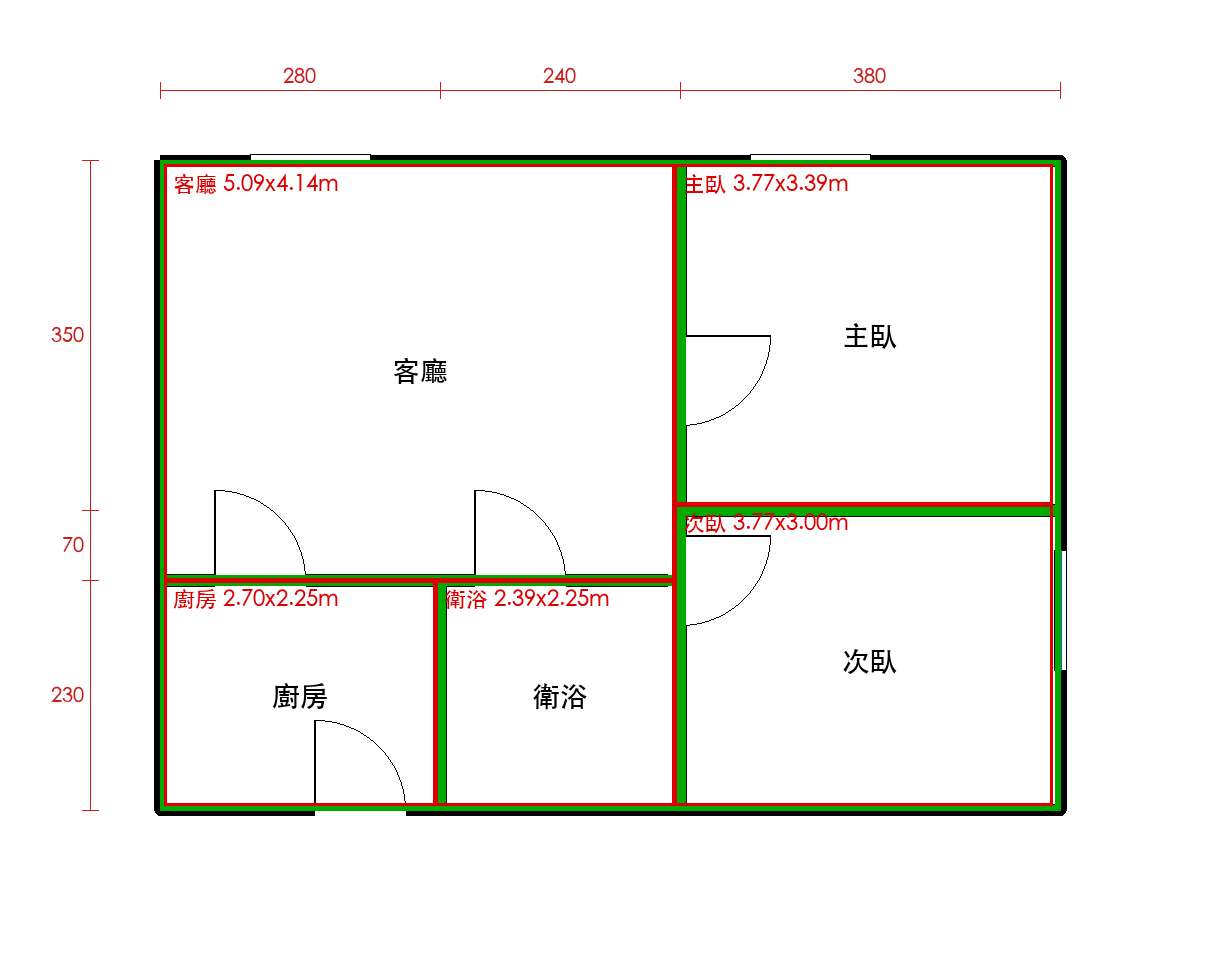
兩房一廳,配置 IoU 0.89(同為不跑 Phase 0 的最終版本;兩次執行分別是 0.89 與 0.98)。

樣本很小:4 張合成圖、1 張真實平面圖,各跑兩次。真實平面圖還是有問題:客廳的頂點順序錯了、畫成交叉的形狀,還多畫了幾個空間(量出 11 或 14 間,實際只有 10 間)。程式碼在獨立分支上(還沒合併、沒開 PR),正式環境的預設值也還沒換(目前仍是開著 Phase 0、用 gemini-2.5-flash)。

4 張合成平面圖(程式產生,1 px = 1 cm)+ 1 張真實上傳平面圖,2026-11-10,各跑兩次,共 7 輪測試。整個評測總共約 $5.0。

評測與實驗

61 個情境,兩個模型的結果

同一份程式碼,2026-11-09 把 61 個情境各跑一次,比較 gemini-3.8-flash 和便宜很多的 gpt-5.6-luna。

59/61 通過(gemini-3.8-flash)

18.4 s
中位時間
$0.0165
每次請求
89% → 97%
評測找出的問題修好前後
設定情境通過中位時間每次成本
gemini-3.8-flash原始 61 個59 / 6118.4 s$0.0165
gpt-5.6-luna原始 61 個56 / 6113.4 s$0.0032
gpt-5.6-luna第二批 25 個(較難)14 / 2522.2 s—
Team route(實驗)61 個中的 16 個,各 2 次30 / 3212.3 s$0.0049

gpt-5.6-luna 的成本約五分之一、快 27%,通過率低 5 個百分點;沒過的多在需要判斷的地方:缺資訊時該先問、放不下時該拒絕、要守住指定的走道寬度。

「通過」指 Agent 做完後的房間符合確定性的幾何與權限檢查,不代表擺得好看,也不是整體準確率:每個情境只跑一次,3.8 的結果涵蓋 52 項能力中的 25 項。

每一列都是同一份程式碼(2026-11-09);成本已計入快取折扣。第二批只在 gpt-5.6-luna 上跑過。
52 項能力,排了優先順序

這套測試後來擴充成一張完整的能力清單:先把使用者可能會說的話分成 8 組、52 項,再對應到工具、Skill,和附標準答案的測試案例。

16
已涵蓋
21
P1 優先
6
P2 優先
5
P3 優先
4
暫緩
  • A 理解與問答7
  • B 單件修改11
  • D 空間問題修正2
  • E 整體佈置6
  • F 設計美感11
  • G 對話與修正5
  • H 邊界與誠實7
  • I 房間環境3

結果52 項能力對應到 13 個工具、9 個 Skill,各自配上附標準答案的測試案例。

更難的第二批:找到的多是產品缺口

原本的情境快滿分了,分不出模型差別,所以我加了 25 個更難的。每題都附一個必須通過的參考解,和必須被判失敗的錯誤解(共 54 個),確認每項檢查真的分得出對錯。

結果gpt-5.6-luna 通過 14/25。11 次失敗裡,明確是模型的錯大約只有 1 次;其餘是產品還沒做到:門口沒留通道、重排時移動了門、不會「圍著桌子」擺、新增時不能指定顏色、不能整組移動,或是檢查本身太嚴。

評測找出問題、修好、再量一次:例如「整理擁擠的客廳」在修好重排之前會失敗,修好後兩次都通過。

實驗:分派給便宜模型,沒有比較划算

理解需求的那一步留在強模型上;只換「誰動手執行」,看便宜模型能不能省時間和成本。

結果16 個情境各跑兩次:30/32 通過,中位 12.3 秒,每次 $0.0049。和直接全用 gpt-5.6-luna 一樣是 94%,成本卻約兩倍,因為理解需求和困難的請求仍交給 3.8,所以沒有採用。

看做法

做法

  1. Leader(便宜模型,沒工具)讀一行需求摘要,原封不動轉給一個成員
  2. Light executor(便宜模型)處理唯讀問題、澄清、單一簡單修改
  3. Full executor(原本的強模型)處理其他所有情況;沒做完的需求交回強模型重試一次

不管哪個成員執行,每次寫入都還是要通過同一個 mutation guard 檢查——分派只決定誰動手,不會放寬權限。

換模型前,先寫測試

10 月要選模型前,我先寫測試:每個情境檢查最後的房間、呼叫的工具和回覆。這套測試後來擴充成上面的 61 個情境;下面是各題型的實際例子。

我做了什麼

我從搬家時的真實困擾定義這個產品,獨立做到 3D 互動、Agent 執行、空間規則和模型評測。除了讓 AI 能動手,也用幾何檢查、寫入邊界、undo 和情境測試,讓結果可以控制、復原和驗證。

2026 年 3–4 月做出 MVP,10 月換模型時加上情境評測。使用 React、Three.js、FastAPI、Agno 與 Gemini,也可以切換 OpenAI 或 Ollama。